시각 자료 분석 · 편집 노트 01
같은 사진인데 다른 인상: 썸네일 네 가지 비율을 비교했어요
가로형은 위아래를, 정사각형은 양옆을 잘랐어요. 같은 파일도 남는 배경이 달라지는 이유를 원본과 계산표로 확인합니다.
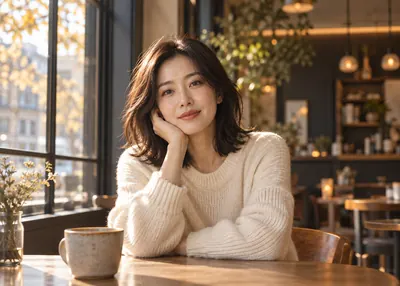
400×286 사진을 정사각형 틀에 중앙 정렬하면 원본의 좌우가 각각 57픽셀씩 잘려 28.5%가 보이지 않습니다. 카페 배경의 같은 사진을 16:9, 1:1, 9:16으로 배치해, 무엇이 남고 무엇이 제외되는지 비교했어요. 이 수치는 원본 좌표로 계산한 면적이며 사람의 시선을 측정한 값은 아닙니다. 표본과 계산 원기록
이번 비교의 핵심: 16:9 가로형에서는 원본 면적의 21.3%, 1:1 정사각형에서는 28.5%, 9:16 세로형에서는 59.8%가 화면 밖으로 나갔어요. 다만 손실 면적이 작다고 언제나 더 좋은 미리보기인 것은 아니었어요. 중요한 단서가 원본의 어디에 있는지가 함께 작용했어요.
사진은 한 장, 바꾼 것은 화면의 비율이에요
표본은 이 사이트를 위해 AI로 생성한 가상 성인 여성의 카페 이미지예요. 실제 출연자나 영상 캡처가 아니며, 비교용 WebP 파일은 400×286 픽셀로 준비했어요. 사진 안의 인물과 배경이 그대로인 상태에서 잘림만 비교하기 위해서예요. 네 칸 모두 동일한 WebP 파일을 사용합니다.
사진의 가로세로 비율을 유지한 채 각 틀을 빈틈없이 채우고, 중심을 가로·세로 모두 50%에 맞췄어요. 틀을 채우는 과정에서 사진 전체의 표시 배율은 달라지고, 틀 밖으로 나간 부분은 보이지 않게 했습니다. 별도 선명화, 색상 변경, 인물 영역 선택은 하지 않았어요. 이 조건은 CSS의 object-fit: cover와 object-position: 50% 50%에 해당해요. 비율을 유지하며 틀을 채우는 동작은 MDN의 object-fit 설명, 중앙 정렬은 object-position 설명과 대조했어요.
원본 비율 외에 16:9, 1:1, 9:16을 비교했어요. 아래 표본은 독자의 화면 너비에 따라 표시 크기가 달라지지만, 각 틀의 비율과 잘림 조건은 유지됩니다. 면적 계산은 원본 좌표를 기준으로 했어요.
네 가지 화면을 나란히 읽어 봤어요
얼굴이 강조돼도 사진 속 사람이 변한 것은 아니에요
C와 D는 얼굴의 모양이나 표정을 바꾼 결과가 아니에요. 인물을 둘러싼 단서가 줄어들어 얼굴이 더 우선적인 정보가 된 거예요. A에서는 창문 옆 카페라는 상황이 함께 읽히지만 D에서는 얼굴과 상체가 화면의 중심이 돼요. 이 차이는 사진에 무엇을 추가했는지가 아니라, 무엇을 남겼는지에서 생겼습니다.
가로형이 정사각형보다 덜 잘려도 항상 유리하지는 않아요
B는 C보다 제외된 면적이 작아요. 그러나 B에서는 위아래의 배경과 테이블이 잘리고 C에서는 원본 높이가 유지돼요. 만약 중요한 단서가 위쪽에 있다면 C가 더 잘 보존할 수도 있어요. 그래서 이 표본으로 ‘가로형이 더 정확하다’는 순위를 만들지는 않았어요. 보존해야 할 단서의 위치를 먼저 정해야 비교 기준이 분명해집니다.
21.3%와 28.5%는 어떻게 계산했나요?
원본 면적은 400×286 = 114,400 제곱픽셀이에요. 원본 좌표에서 화면에 남는 직사각형의 면적을 구한 뒤 전체와 비교했어요. 여기서 제곱픽셀은 계산 단위예요. 압축 파일의 바이트 수나 영상 데이터 양을 뜻하지 않습니다.
| 틀 | 보이는 원본 영역 | 제외된 면적 | 잘림 방향 |
|---|---|---|---|
| 원본 비율 | 400×286 | 0% | 없음 |
| 16:9 | 400×225 | 21.3% | 위·아래 각 30.5px |
| 1:1 | 286×286 | 28.5% | 좌·우 각 57px |
| 9:16 | 160.875×286 | 59.8% | 좌·우 각 119.5625px |
제외 비율 = (1 − 보이는 영역 ÷ 원본 영역) × 100
16:9 → (1 − (400 × 225) ÷ (400 × 286)) × 100 ≈ 21.3%
1:1  → (1 − (286 × 286) ÷ (400 × 286)) × 100 = 28.5%
가로형의 높이는 400×9÷16 = 225예요. 원본 높이 286과의 차이 61을 위아래로 나누면 각각 30.5가 됩니다. 세로형은 높이 286을 유지하므로 폭이 286×9÷16 = 160.875가 돼요. 소수점 좌표는 기하 계산 결과이며, 실제 화면에서는 기기 배율과 렌더링에 따라 픽셀 경계가 반올림될 수 있어요.
야동토끼에서 콘텐츠를 고를 때 적용해 본다면
성인 콘텐츠를 찾는 과정에서도 미리보기는 관심을 정하는 데 도움이 되지만, 모든 질문에 답하지는 못해요. 이번 비교에서 쓸 만했던 방법은 판단할 대상을 작게 나누는 것이었어요.
- 분위기가 궁금할 때: 얼굴만 보지 말고 배경이나 주변 인물·사물이 남아 있는지도 봐요. 주변이 잘렸다면 장면 전체의 분위기는 아직 모르는 상태예요.
- 내용의 진행이 궁금할 때: 정지 이미지에 순서나 길이를 덧붙여 상상하지 않아요. 재생 시간과 별도 설명은 썸네일과 다른 종류의 정보예요.
- 다른 카드가 같은 콘텐츠처럼 보일 때: 비슷한 얼굴이나 색만으로 중복이라고 정하지 않아요. 카드 비율과 잘림 위치가 다르면 같은 사진도 다른 인상을 줄 수 있고, 반대로 비슷한 이미지가 다른 콘텐츠에 사용될 수도 있어요.
가령 B와 C를 서로 다른 목록에서 봤다고 생각해 보세요. B는 가로 장면, C는 인물 중심 소개처럼 느껴질 수 있지만 여기서는 같은 파일이에요. 이 사례는 사진만으로 콘텐츠의 동일성이나 차이를 확정하기 어렵다는 작은 반례가 됩니다. 실제 목록의 중복 여부를 조사한 통계는 아니에요.
선택 전에 남길 질문: ‘이 이미지가 무엇을 보여 주는가?’와 함께 ‘지금 잘려서 보이지 않는 정보는 무엇인가?’를 물어보세요. 답이 없는 부분을 억지로 채우지 않는 것이, 더 자극적인 설명을 찾는 것보다 기대 차이를 줄이는 데 도움이 됩니다.
이 비교로는 화질·안전성·전체 내용을 평가할 수 없어요
비교 대상은 한 장의 AI 생성 이미지이므로 모든 미리보기에 같은 인상 변화가 생긴다고 일반화할 수 없어요. 인물이 중앙이 아닌 사진, 여러 사람이 등장하는 장면, 배경에 중요한 단서가 있는 사진에서는 결과가 달라질 수 있어요. 시선이 어디로 이동했는지 측정한 사용자 실험도 아니며, 인상에 대한 설명은 이 글의 시각적 해석이에요.
잘림 비율과 전송량도 나눠야 해요. 이번 표본은 동일한 17,188바이트 WebP 파일을 공유하므로 작은 틀에 넣었다고 작은 파일로 바뀌지 않아요. 파일 크기는 원기록의 source.bytes에서 확인할 수 있어요. 59.8%가 보이지 않는다는 값은 데이터 요금이 그만큼 절약된다는 뜻이 아닙니다. 실제 전송량은 파일 자체와 캐시 등 별도의 조건을 확인해야 해요.
마지막으로, 썸네일은 등장인물의 성인 여부나 촬영·배포 동의를 증명하지 않아요. 화질과 구도를 아무리 자세히 보더라도 그런 확인을 대신할 수 없습니다. 이번 글은 콘텐츠의 적법성이나 특정 외부 서비스의 신뢰도를 인증하는 평가가 아니라, 보이는 장면과 아직 알 수 없는 내용을 구분하는 비교예요.